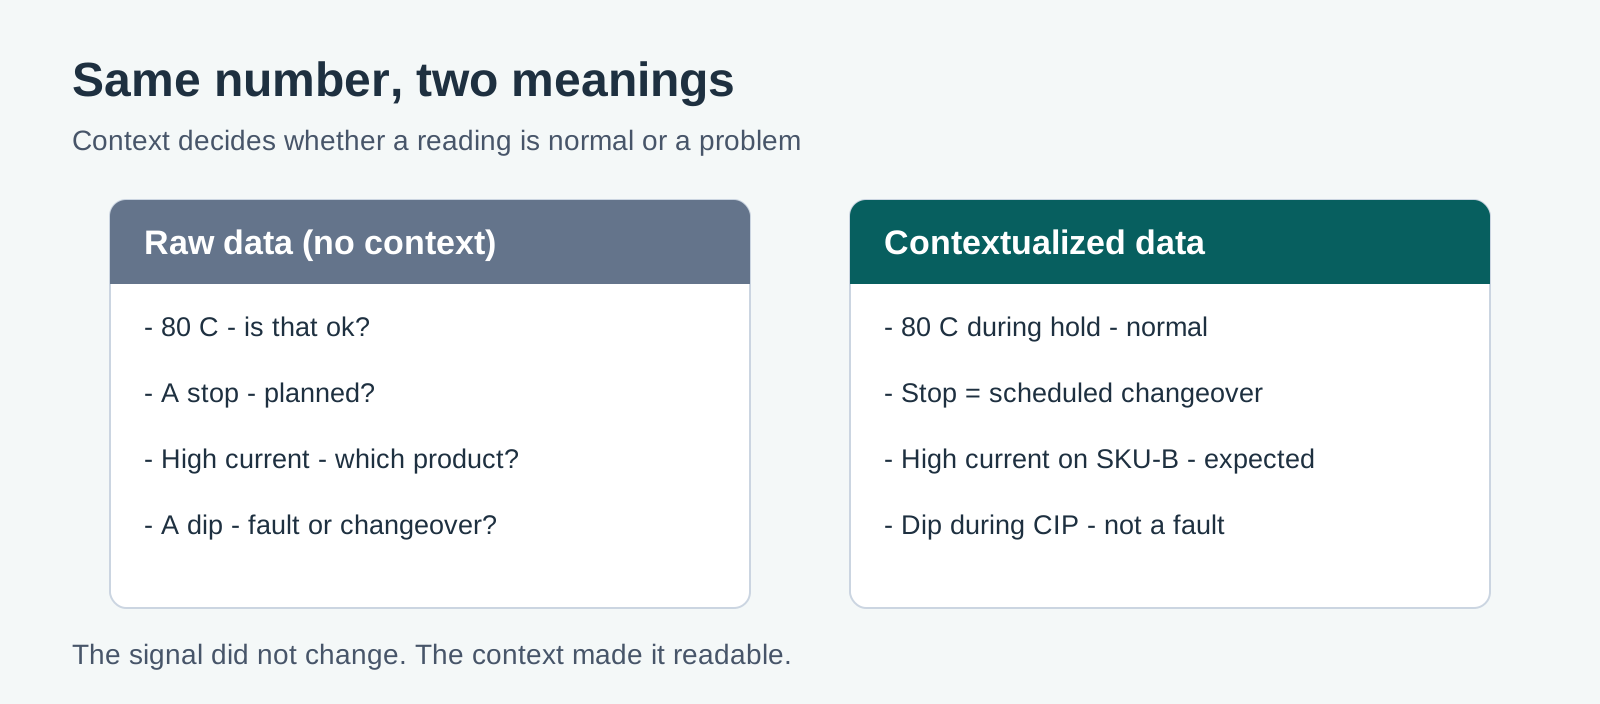
Ein Temperaturwert von 80 C bedeutet fuer sich genommen nichts. Auf der einen Linie ist er voellig normal; auf einer anderen eine Warnung; waehrend eines Reinigungszyklus ist er erwartet. Die Zahl ist identisch - nur der Kontext sagt Ihnen, welche Geschichte stimmt. Deshalb sind Rohdaten aus der Fabrik, egal wie viele Sie sammeln, nichts, was KI so verwenden kann.
Dieser Beitrag beantwortet eine klar abgegrenzte Frage: Warum brauchen Fabrikdaten Kontext, bevor KI sie nutzen kann, und was bedeutet "Kontext" eigentlich?
Rohsignale sind von Natur aus mehrdeutig
Ein Sensor meldet einen Wert. Er meldet nicht, welches Produkt lief, ob die Maschine hochfuhr oder hielt, was der Bediener tat oder ob ein Stopp geplant war. Nimmt man das weg, bleiben Zahlen, die Gegensaetzliches bedeuten koennen. Fuettert man damit ein Modell, lernt es Rauschen.
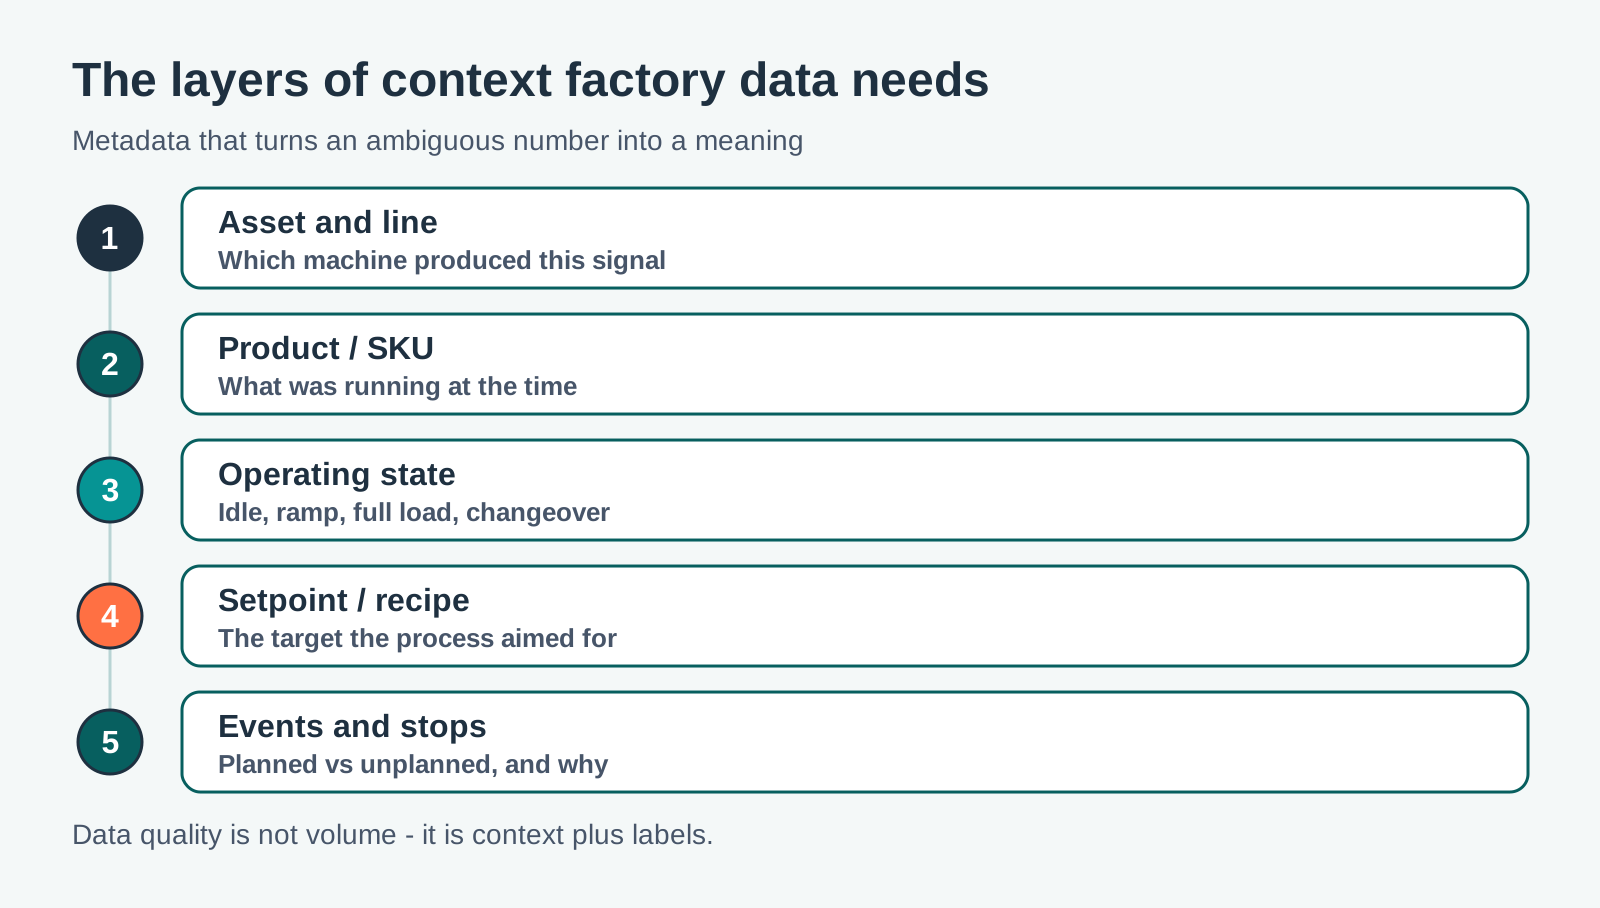
Was "Kontext" in der Praxis bedeutet
Kontext sind die Metadaten, die ein Signal eindeutig machen - die Betriebsbedingungen, unter denen die Zahl entstand.
Ohne Kontext produziert KI Fehlalarme - oder lernt nichts
Geben Sie einem Modell unkontextualisierte Daten, passiert eines von zwei Dingen. Entweder es markiert normale-aber-andere Betriebszustaende als Anomalien (Fehlalarme, die Vertrauen zerstoeren), oder es mittelt alles zusammen und lernt ein verschwommenes "Normal", das nichts faengt. Beide Fehler haben dieselbe Wurzel: die Daten sagten nie, aus welcher Situation sie stammten.
Datenqualitaet ist Kontext, nicht Menge
Fabriken nehmen oft an, mehr Daten bedeute bessere KI. Aber ein Jahr ungelabelter, unkontextualisierter Signale ist ein Jahr Mehrdeutigkeit im grossen Massstab. Echte industrielle Datenqualitaet ist das Gegenteil von Menge: sie bedeutet, fuer jeden Signalabschnitt Produkt, Zustand, Sollwert und die umgebenden Ereignisse zu kennen. Das erst laesst ein Modell Gleiches mit Gleichem vergleichen.
Use Case in der Praxis: ein Pharma-Bioreaktor
In einem Biologika-Werk schwanken Temperatur und pH eines Bioreaktors bauartbedingt stark ueber eine Charge: Inokulation, Wachstum und Ernte haben jeweils ihr eigenes "Normal". Ein roher Wert von 37,5 C ist bedeutungslos, ohne die Phase zu kennen.
- Das Problem: ein Alarm auf absoluter Temperatur loest in Ramp-Phasen staendig aus und verpasst eine echte Drift in der Halte-Phase.
- Der ergaenzte Kontext: Chargenphase, Produkt/Stamm, Sollwert je Phase und Ruehr-/Belueftungszustand.
- Das Ergebnis: mit angehaengtem Kontext lernt das Modell ein eigenes "Normal" je Phase und markiert nur relevante Abweichungen - eine langsame Drift in der Halte-Phase, nicht die erwartete Schwankung im Wachstum.
- Warum es funktioniert: das Rohsignal aenderte sich nie. Der Kontext machte es interpretierbar.
Praktische Regel
Bevor Sie fragen, ob Sie genug Daten fuer KI haben, fragen Sie, ob Ihre Daten genug Kontext haben. Signale plus Kontext plus Labels - das ist, was "KI-taugliche Daten" wirklich bedeutet, und es ist meist ein Labeling-Problem, kein Sensor-Problem. (Siehe auch unseren Beitrag zum Data Labeling.)
Machen Sie einen Datensatz KI-tauglich. Importieren Sie Ihre Signale und haengen Sie den Kontext an - Produkt, Zustand, Sollwert, Ereignisse - der aus mehrdeutigen Zahlen Bedeutung macht, in Predsense Labeling: https://www.predsense.ai/products/labeling