Stellen Sie einen talentierten Data Scientist ein, setzen Sie ihn auf die Fertigung an, und oft passiert etwas Ueberraschendes: sehr wenig. Nicht weil ihm das Koennen fehlt - er kann jeden im Gebaeude ueber-modellieren - sondern weil die Fertigung fast jede Annahme bricht, auf der seine Ausbildung beruht. Der schwere Teil von Industrie-KI ist selten der Algorithmus. Es ist alles drumherum: keine Labels, implizites Domaenenwissen, unordentliche Signale und Operatoren, die dem Ergebnis vertrauen muessen. Genau darauf bereitet ein klassischer Data-Science-Hintergrund nicht vor.
Dieser Beitrag beantwortet eine klar abgegrenzte Frage: Warum scheitern starke Data Scientists in der Fertigung - und was laesst Industrie-KI wirklich funktionieren?
Zwei verschiedene Welten
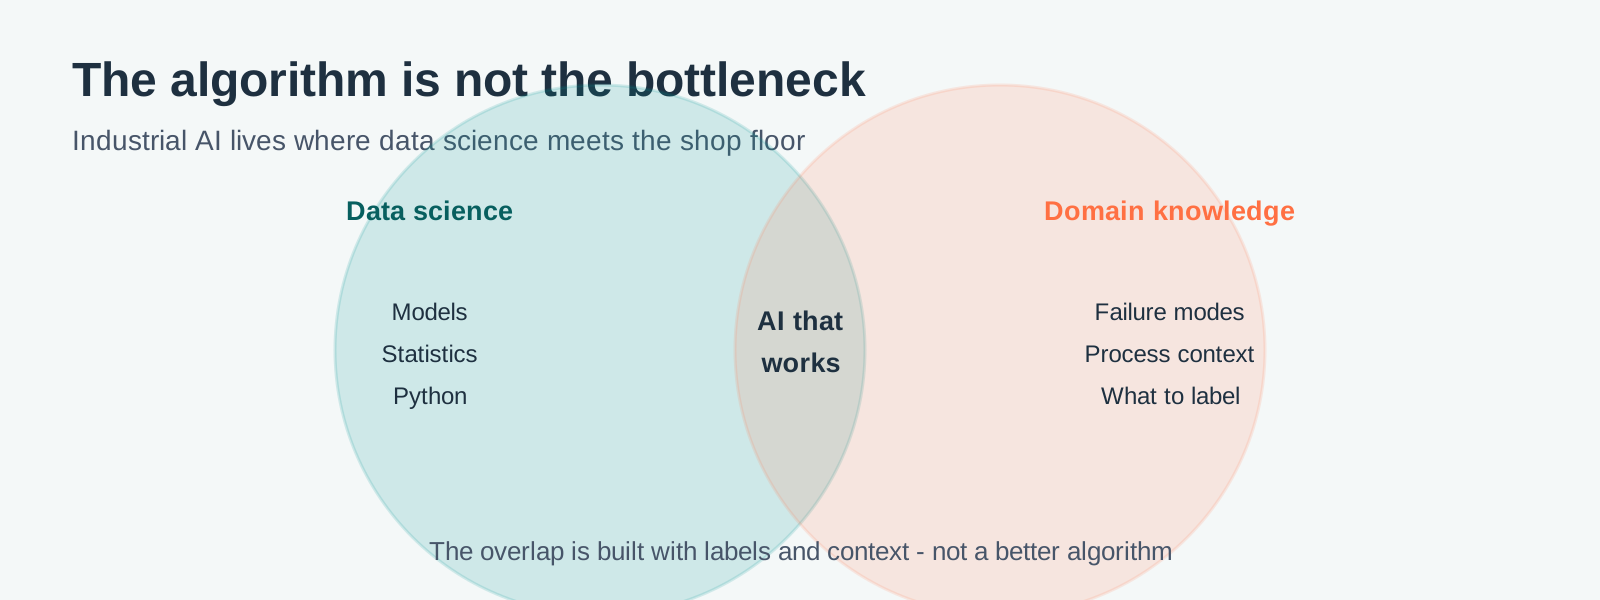
Data Science bringt Modelle, Statistik und Code. Die Fertigung bringt Fehlermodi, Prozesskontext und das Wissen, was "abnormal" ueberhaupt bedeutet. Industrie-KI funktioniert nur in der Ueberschneidung - und diese Ueberschneidung wird mit Labels und Kontext gebaut, nicht mit einem besseren Algorithmus. Ein Data Scientist, der im linken Kreis bleibt, so brillant er auch ist, erreicht sie nicht allein.
Wo das Playbook bricht
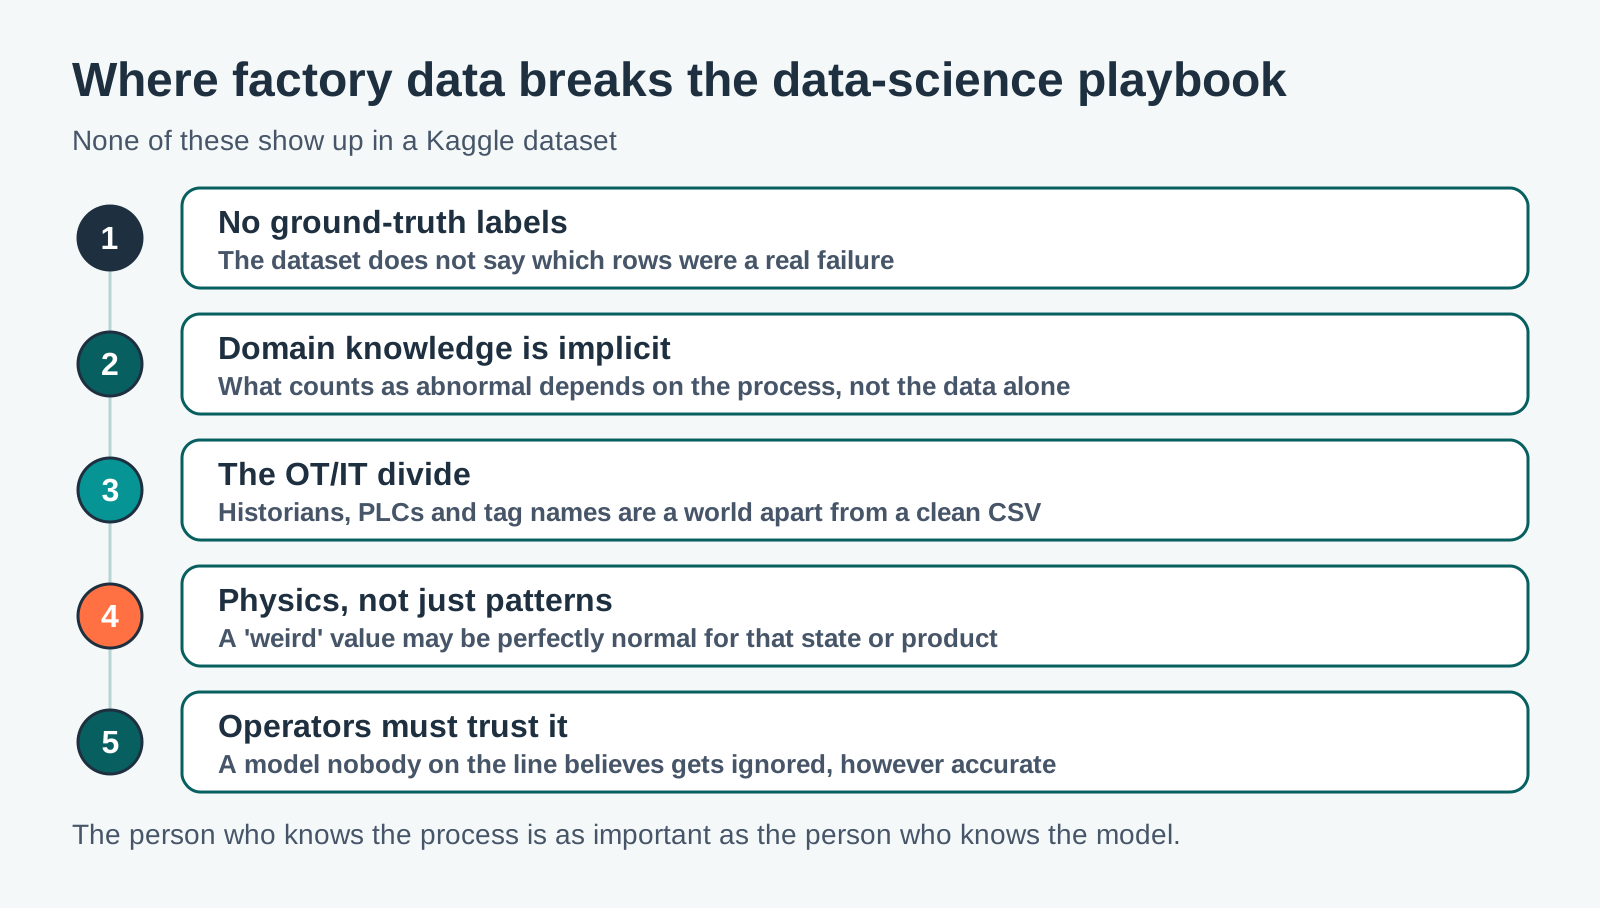
Der uebliche Data-Science-Workflow setzt einen gelabelten Datensatz, saubere Merkmale und eine klare Metrik voraus. Die Fertigung bietet nichts davon standardmaessig: es gibt keine Spalte, die sagt, welche Zeilen ein echter Ausfall waren, "abnormal" haengt von Prozesswissen ab, das die Daten allein nicht tragen, und die Daten leben in Historians und SPSen, die nichts mit einer sauberen CSV zu tun haben. Dazu kann ein Wert, der seltsam aussieht, fuer diesen Zustand oder dieses Produkt voellig normal sein - und ein Modell, dem niemand an der Linie vertraut, wird ignoriert, wie genau es auch ist.
Warum das ein Menschen-Problem ist, kein Talent-Problem
Nichts davon bedeutet, dass Data Scientists nicht wertvoll sind - sie sind unverzichtbar. Es bedeutet, dass sie nicht allein arbeiten koennen. Die fehlende Haelfte ist die Person, die den Prozess kennt: welche Signale zaehlen, wie ein normaler Wechsel aussieht, welche vergangenen Ereignisse echte Ausfaelle waren. Dieses Wissen macht aus Rohdaten gelabelte, trainierbare Daten. (Deshalb argumentieren wir auch, dass KI-Einfuehrung mehr mit Menschen als mit Technik zu tun hat, und warum Ingenieure - nicht nur Programmierer - Modelle trainieren koennen sollten.)
Use Case in der Praxis: eine Snack-Extrusions- und Verpackungslinie
Ein Lebensmittelhersteller setzt einen Data Scientist auf seine Extrusions- und Verpackungslinie an, um Verstopfungen und Siegelfehler vorherzusagen. Der Historian-Export ist eine Wand aus kryptischen Tags ohne Einheiten; die "Ausfaelle" leben in einem Wartungslogbuch in einem anderen System; und was in den Daten wie eine Anomalie aussieht, ist oft nur ein Rezeptwechsel, von dem der Data Scientist nichts wusste. Nach Wochen entdeckt das Modell vor allem wieder, dass die Linie fuer verschiedene Produkte unterschiedlich laeuft - etwas, das jeder Operator am ersten Tag haette sagen koennen.
Das Projekt dreht sich erst, als ein Linieningenieur sich mit dem Data Scientist zusammensetzt: gemeinsam kartieren sie, welche Tags was bedeuten, markieren die echten Verstopfungs- und Siegelfehler-Ereignisse in der Historie und erklaeren, welche "seltsamen" Muster nur Produktwechsel sind. Jetzt hat der Data Scientist gelabelte, kontextreiche Daten - und das Modell lernt endlich etwas Echtes.
Wie Sie es aufsetzen wuerden
- Signale: Extruder-Motorlast, Zylindertemperaturen und -druck, Schneckendrehzahl, Siegeltemperatur und Folienspannung - aus der SPS.
- Kontext (aus der Fertigung): Produkt und Rezept, Laufphase und welcher Tag welcher ist, geliefert von den Menschen, die die Linie fahren.
- Was Sie labeln (gemeinsam): vergangene Verstopfungen und Siegelfehler aus dem Logbuch, von dem Ingenieur, der dabei war, mit den Daten abgeglichen. (Siehe unsere Beitraege dazu, was Data Labeling ist und warum Fabrikdaten Kontext brauchen.)
- Wem es gehoert: der Data Scientist baut das Modell; der Linieningenieur besitzt die Grundwahrheit. Keiner funktioniert ohne den anderen.
Praktische Regel
Loesen Sie ein Industrie-KI-Problem nicht allein mit Data-Science-Talent. Kombinieren Sie es mit Domaenenwissen und geben Sie beiden ein gemeinsames Werkzeug, um Prozesswissen in gelabelte Daten zu verwandeln. Der Engpass war nie die Mathematik - es war der Kontext, den nur die Fertigung liefern kann.
Domaenenwissen wird durch Labeling zu KI. Lassen Sie Ihre Prozessexperten markieren, was zaehlt - Signale importieren, Kontext ergaenzen und ihr Know-how als Labels erfassen, in Predsense Labeling: https://www.predsense.ai/products/labeling