Viele Predictive-Maintenance-Programme bleiben bei derselben Frage stehen: Haben wir genug Daten? Ehrlich gesagt brauchen Sie selten perfekte Daten am ersten Tag. Sie brauchen die richtigen Schichten, sinnvoll verbunden fuer Modelle und Operatoren.
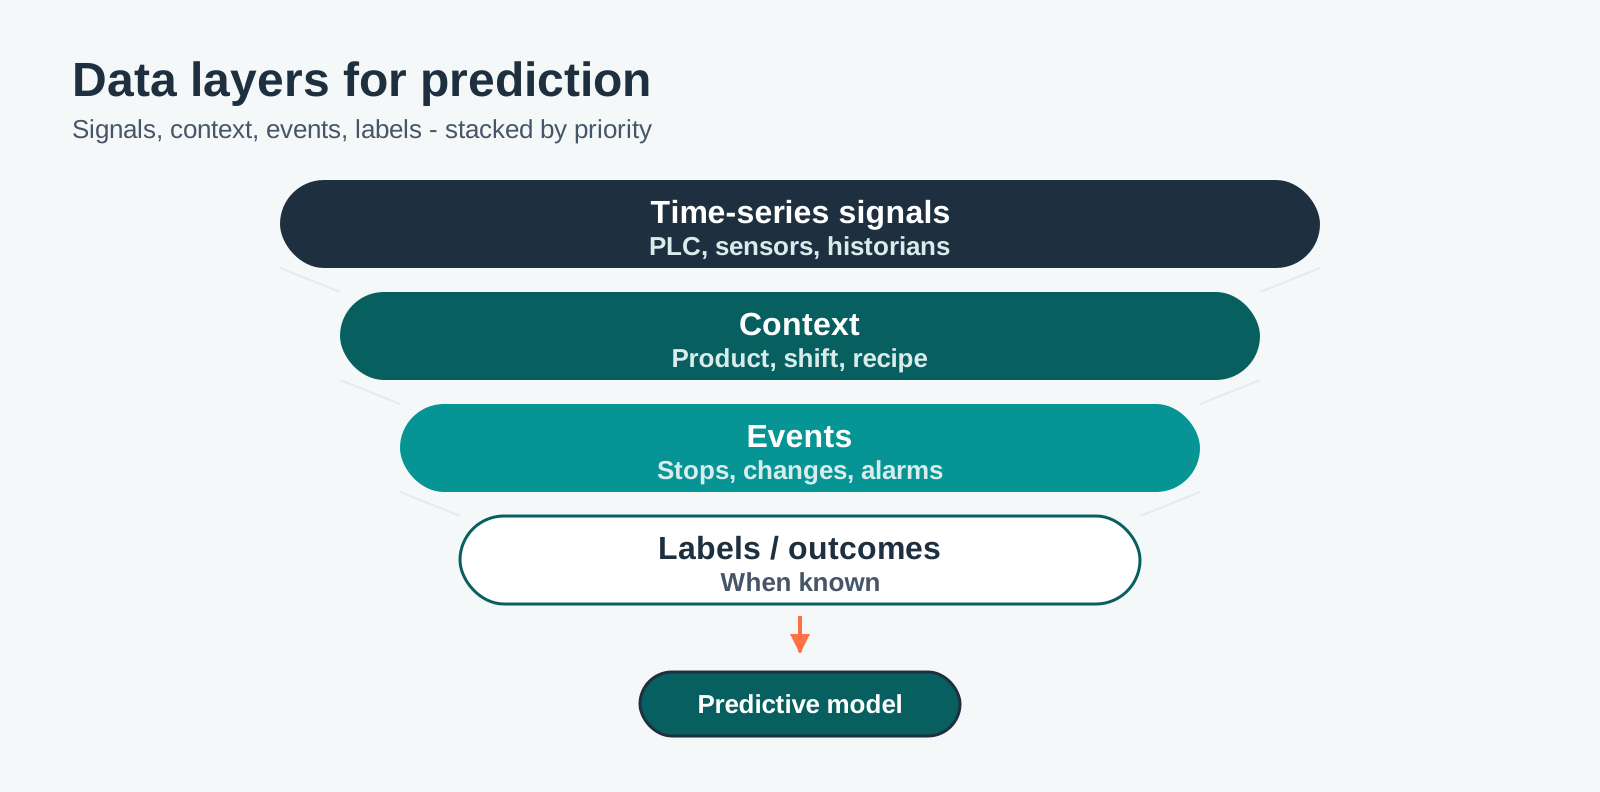
Schicht 1: Zeitreihensignale
Die Basis. Signale aus SPS, SCADA, Historian oder vorhandenen Sensoren - Geschwindigkeit, Temperatur, Druck, Vibration (z. B. Motorstrom), Durchfluss, Drehmoment - in konsistentem Intervall fuer eine definierte Anlage oder Linie. Ohne Zeitreihen keine Drift- oder Fruehwarnmuster.
Schicht 2: Kontext
Rohsignale ohne Kontext erzeugen Fehlalarme. Kontext verbindet Datenpunkte mit dem Geschehen: Produkt/SKU, Rezept, Schicht, Charge, Sollgeschwindigkeit, Umgebung. So wird aus "Temperatur stieg" -> "Temperatur stieg bei SKU-Wechsel auf Linie 3."
Schicht 3: Events
Zeitgestempelte Ereignisse erklaeren Spruenge: Stillstande, Fehlercodes, Umruestungen, Wartung, Quality Holds. Events verankern Modelle in der operativen Realitaet.
Schicht 4: Labels und Outcomes (wenn verfuegbar)
Labels sind nicht zwingend zum Start, aber sie beschleunigen Lernen: bestaetigte Ausfaelle, getauschte Komponenten, RCA-Kategorien, Work-Order-Ergebnisse. Auch partielle Labels aus Wartungslogs helfen.
Minimum Viable Data Set
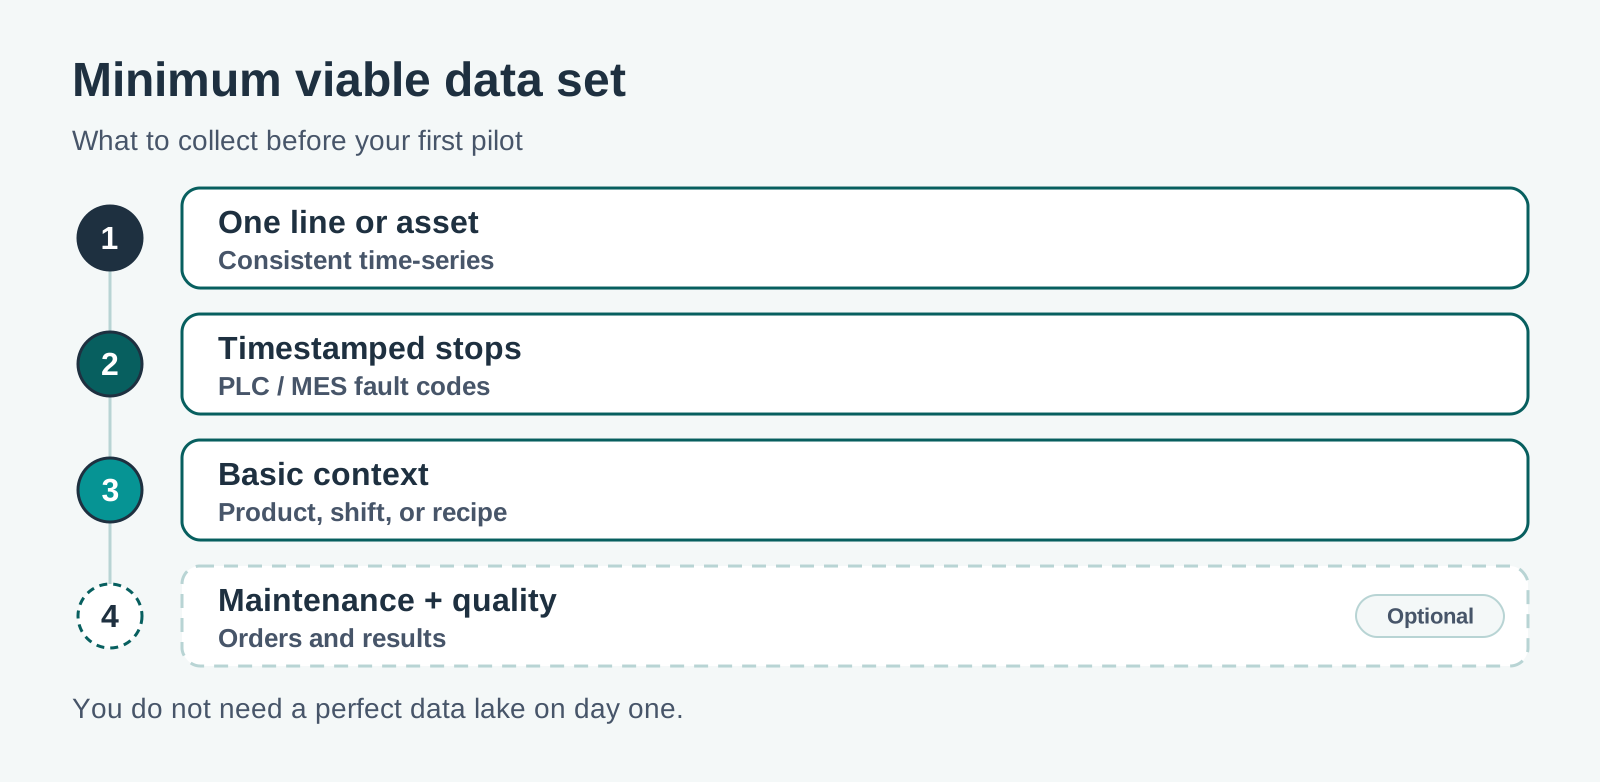
Fuer einen Pilot reicht oft:
- Eine Linie oder Anlagenklasse mit konsistenten Zeitreihen
- Stop/Start oder Fehlercodes aus SPS oder MES
- Basis-Kontext (Produkt, Schicht oder Rezept)
- Optional: Wartungsauftraege und Qualitaetsergebnisse
Was Sie am ersten Tag nicht brauchen
- Unternehmensweiten Data Lake
- Neue Sensorhardware auf jeder Anlage
- Jahre perfekt gelabelter Ausfallhistorie
- Vollstaendig vereinheitlichtes ERP/MES/SCADA vor dem Pilot
Datenqualitaet schrittweise verbessern
Eng starten. Signale fuer einen Use Case zusammenfuehren, mit Fachexpert:innen "normal" definieren, Outcomes bei Ausfaellen erfassen und ins Modell zurueckspeisen. Jede Schleife verbessert Praezision und Vertrauen.
Praktische Regel
Wenn Sie fuer eine Anlage drei Fragen beantworten koennen - welche Signale vor Problemen kippen, welcher Kontext normal ist, welche Events Stopps markieren - koennen Sie starten. Der Rest ist Skalierung.
Von Schichten zum gelabelten Datensatz (in der Praxis)
Die vier Schichten sind kein abstraktes Data-Lake-Thema. Auf einer Pilot-Linie verbinden Teams sie mit nachvollziehbaren Annotationen:
- Import von SPS/Historian-Exporten (CSV oder Excel) als Zeitreihen-Basis
- Kontext an Events haengen - Produkt, Schicht, Fehlercode, Wartung - auf die richtigen Zeitfenster
- Stopps und Anomalien manuell im Chart labeln oder per Regeln, wenn dasselbe Schwellenmuster wiederkehrt
- KI-gestuetzte Suche, um Kandidaten-Anomalien in Klartext zu finden, bevor Labels feststehen
- Export gelabelter Zeitreihen fuer Modelle, ROI-Nachweis oder Reliability Engineering
Perfekte Labels vor dem ersten Upload sind nicht noetig. Start mit Signalen plus Stopps; Kontext und Anomalie-Labels kommen, wenn Operatoren validieren, was relevant war.
Mit einer Anlage testen: Beispieldatei hochladen, Kontext an Events, Anomalien labeln und ein Minimum Viable Dataset in Predsense Labeling exportieren: https://www.predsense.ai/products/labeling