Die meiste industrielle KI scheitert nicht, weil das Modell falsch war. Sie scheitert nach dem Demo, wenn aus einem vielversprechenden Piloten nie ein Produktivsystem wird. Das ist so haeufig, dass es einen Namen hat: Pilot-Fegefeuer. Und die Zahlen ernuechtern - in der BCG-Studie 2024 "Where's the Value in AI?", einer Befragung von 1.000 Fuehrungskraeften in 59 Laendern, kamen nur 26% der Unternehmen ueber den Proof-of-Concept hinaus zu echtem Wert. Rund 70% der Huerden waren Menschen und Prozesse, nicht der Algorithmus.
Dieser Beitrag beantwortet eine klar abgegrenzte Frage: Warum gelingen so viele KI-Projekte in der Fertigung als Pilot und scheitern dann beim Skalieren?
Warum Piloten grossartig aussehen
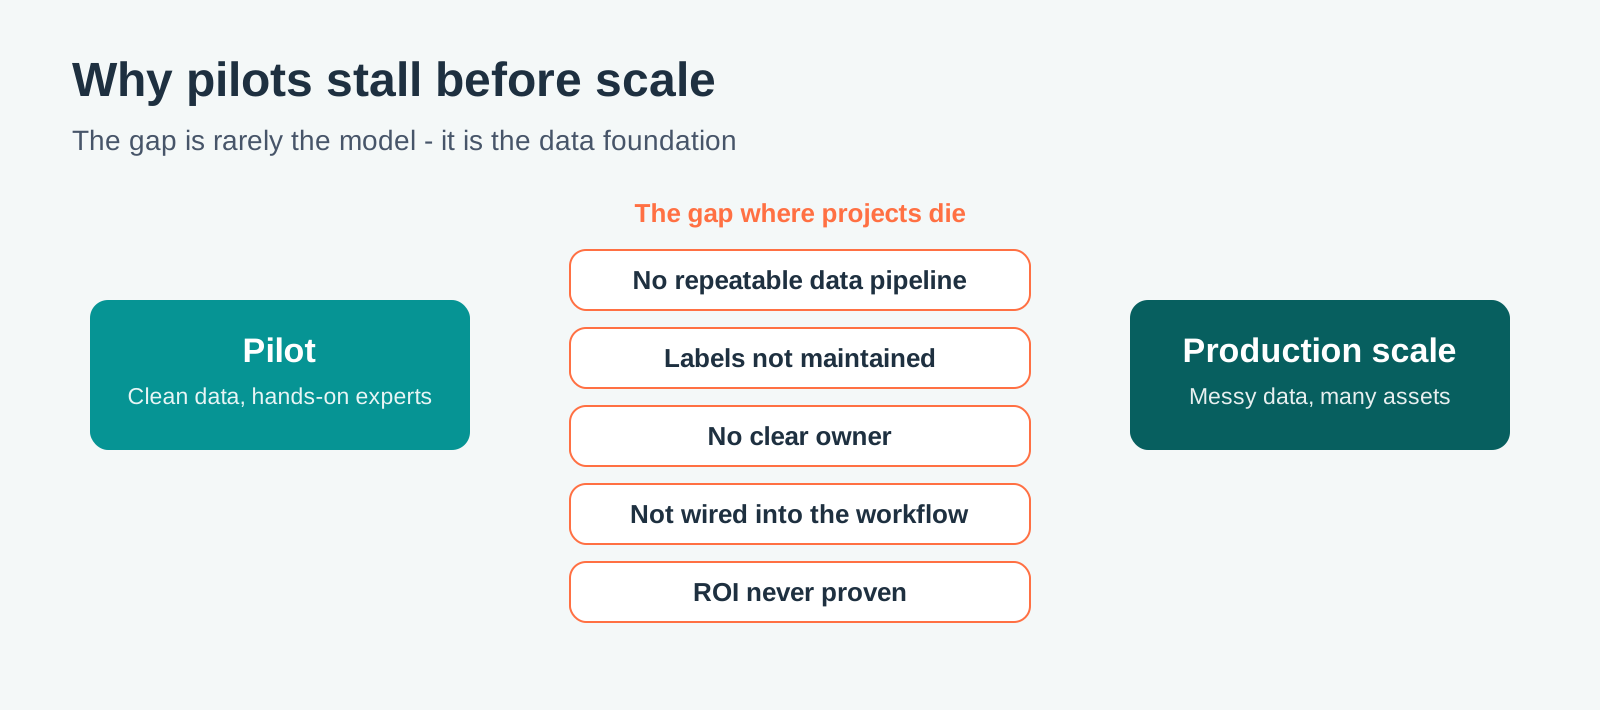
Ein Pilot laeuft mit Heimvorteil: ein kuratierter Ausschnitt sauberer Daten, eine brave Linie und die volle Aufmerksamkeit von Experten, die Probleme manuell beheben, sobald sie auftreten. Natuerlich funktioniert er. Das Demo beweist, dass das Modell funktionieren kann - nicht, dass die Organisation es betreiben kann.
Wo es auf dem Weg in die Produktion bricht
- Keine wiederholbare Datenpipeline. Die Pilotdaten wurden einmal von Hand aufbereitet. Produktion braucht taeglich neue Daten, bereinigt und kontextualisiert.
- Labels werden nicht gepflegt. Jemand hat den Pilotdatensatz einmal gelabelt. In der Produktion passieren weiter Ereignisse, aber niemand markiert sie, also veraltet das Modell.
- Kein klarer Verantwortlicher. Nachdem die Data Scientists weg sind, besitzt niemand im Werk das Modell.
- Nicht in den Arbeitsablauf eingebunden. Ein Alarm, der nicht die handelnde Person erreicht, aendert nichts.
- ROI nie belegt. Ohne gemessenes Ergebnis gibt es kein Budget zum Skalieren.
Das eigentliche Problem ist das Datenfundament
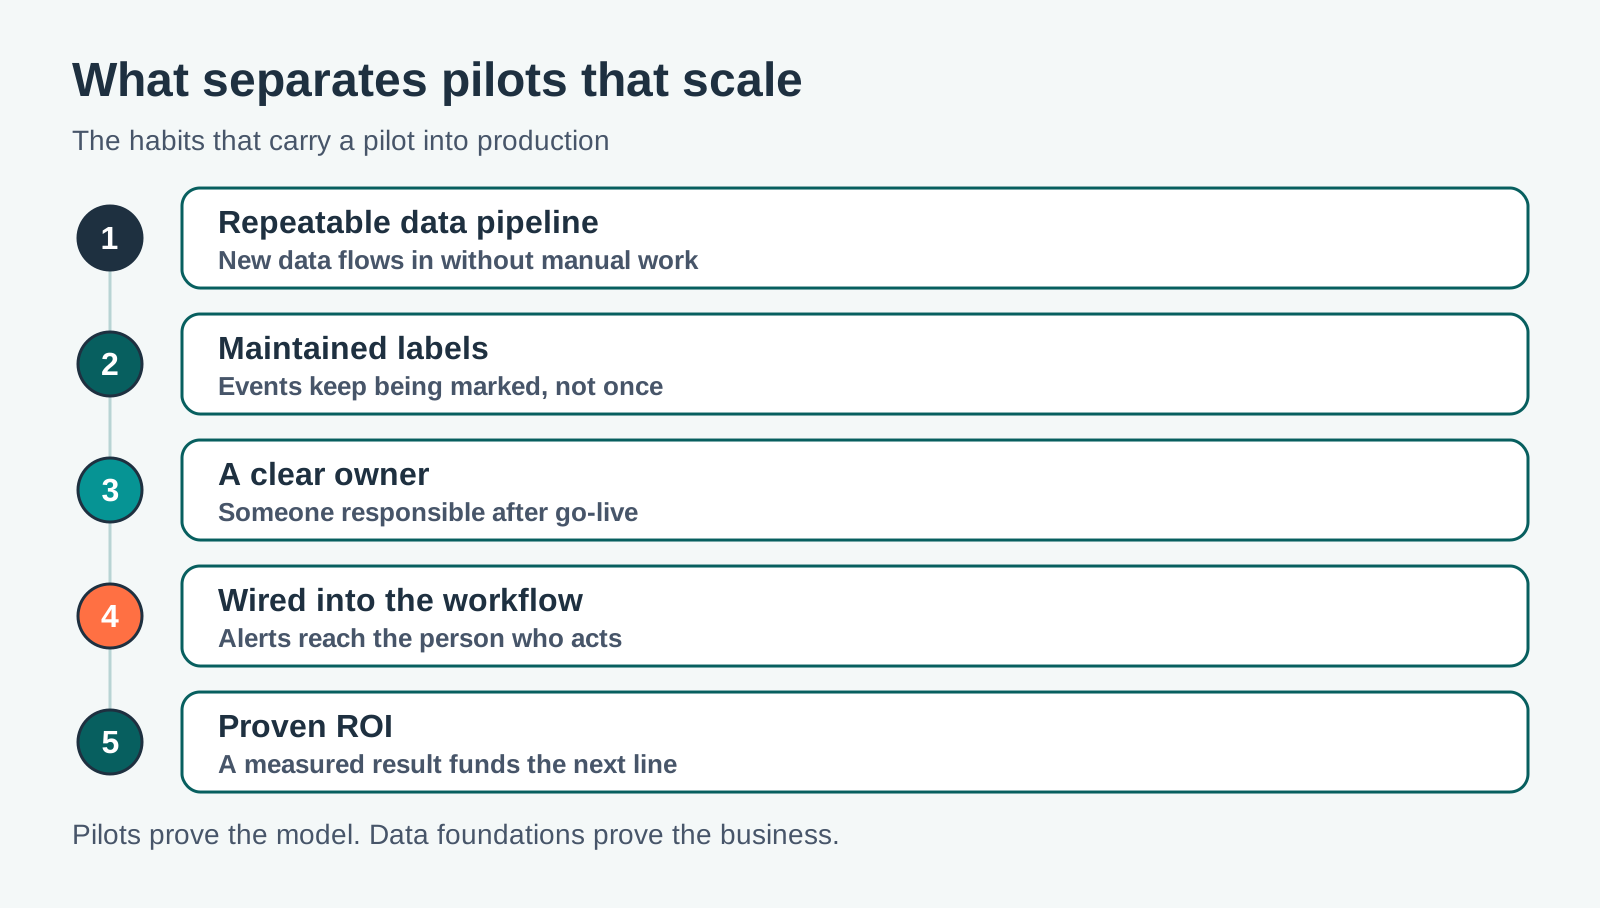
Beachten Sie: Vier dieser fuenf Fehlerquellen betreffen Daten, nicht das Modell. Piloten optimieren das Modell; Produktion verlangt ein Fundament - einen wiederholbaren Fluss kontextualisierter, gelabelter Daten mit einem Verantwortlichen. BCGs Befund, dass ~70% der Schwierigkeit Menschen und Prozesse sind, ist dieselbe Botschaft von der anderen Seite: der Algorithmus war nie der Engpass.
Use Case in der Praxis: Skalierung ueber Molkerei-Abfuelllinien
Ein Molkereibetrieb betreibt einen Predictive-Maintenance-Piloten an einer Abfuelllinie. Er funktioniert hervorragend - der Data Scientist hat sechs Monate an Stopps von Hand gelabelt und das Modell erkennt Ausfaelle frueh. Dann sollen elf weitere Linien folgen.
- Was bricht: jede Linie hat andere Produkte, Geschwindigkeiten und Stoppmuster; der handgelabelte Datensatz laesst sich nicht uebertragen, und niemand labelt die Ereignisse der neuen Linien.
- Warum es stockt: es gibt keine Pipeline, um die Daten jeder Linie einzubringen und zu kontextualisieren, und keinen Verantwortlichen, der die Labels pflegt, nachdem das Pilotteam weiterzieht.
- Was es loest: ein wiederholbarer Labeling-Workflow, den die Linieningenieure selbst nutzen, sodass jede Linie ihre eigene kontextualisierte Historie aufbaut - und das Modell skaliert, weil das Datenfundament mitskaliert.
Praktische Regel
Um vom Pilot in die Produktion zu kommen, hoeren Sie auf zu fragen "funktioniert das Modell?" und fragen Sie "koennen wir das ohne Heldentaten fuettern und pflegen?" Gewinnen Sie eine Linie mit einer wiederholbaren, gelabelten Datenpipeline und einem benannten Verantwortlichen, belegen Sie den ROI, und die zweite Linie ist ein Rollout - kein weiterer Pilot.
Entkommen Sie dem Pilot-Fegefeuer, indem Sie ein wiederholbares Datenfundament bauen. Richten Sie einen Labeling-Workflow ein, den Ihre Ingenieure besitzen, Linie fuer Linie, in Predsense Labeling: https://www.predsense.ai/products/labeling