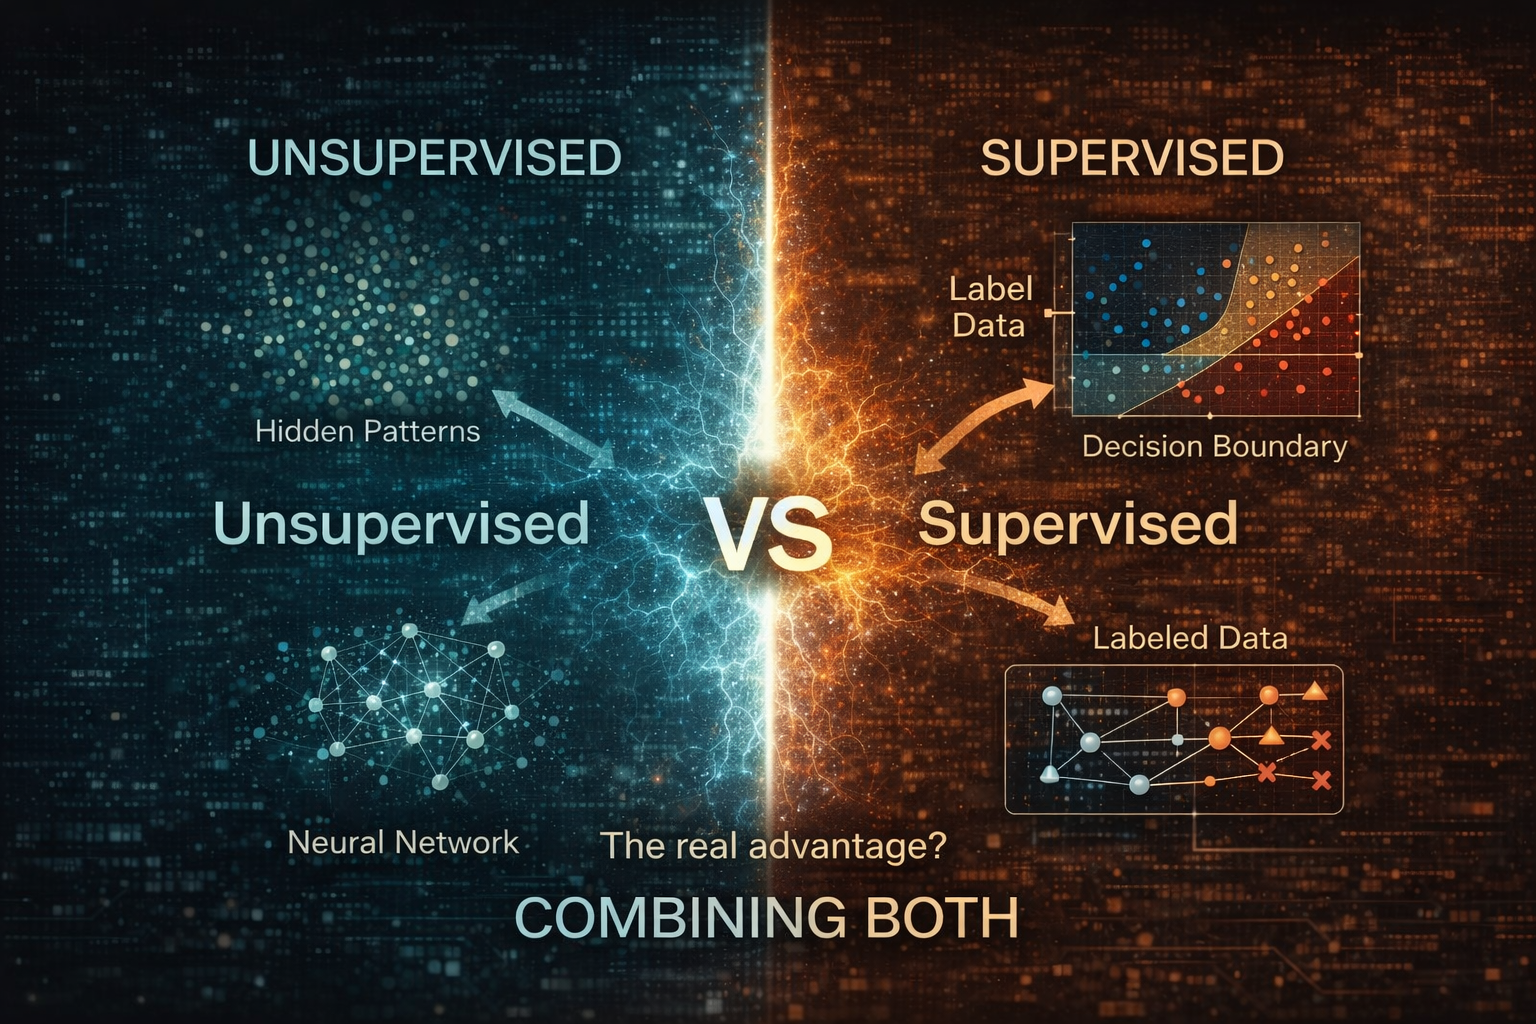
Supervised vs Unsupervised - das klingt nach einer technischen Wahl. In der Praxis ist es vor allem eine Business-Entscheidung: Wollen Sie aus Daten vor allem Bekanntes skalieren - oder Neues entdecken?
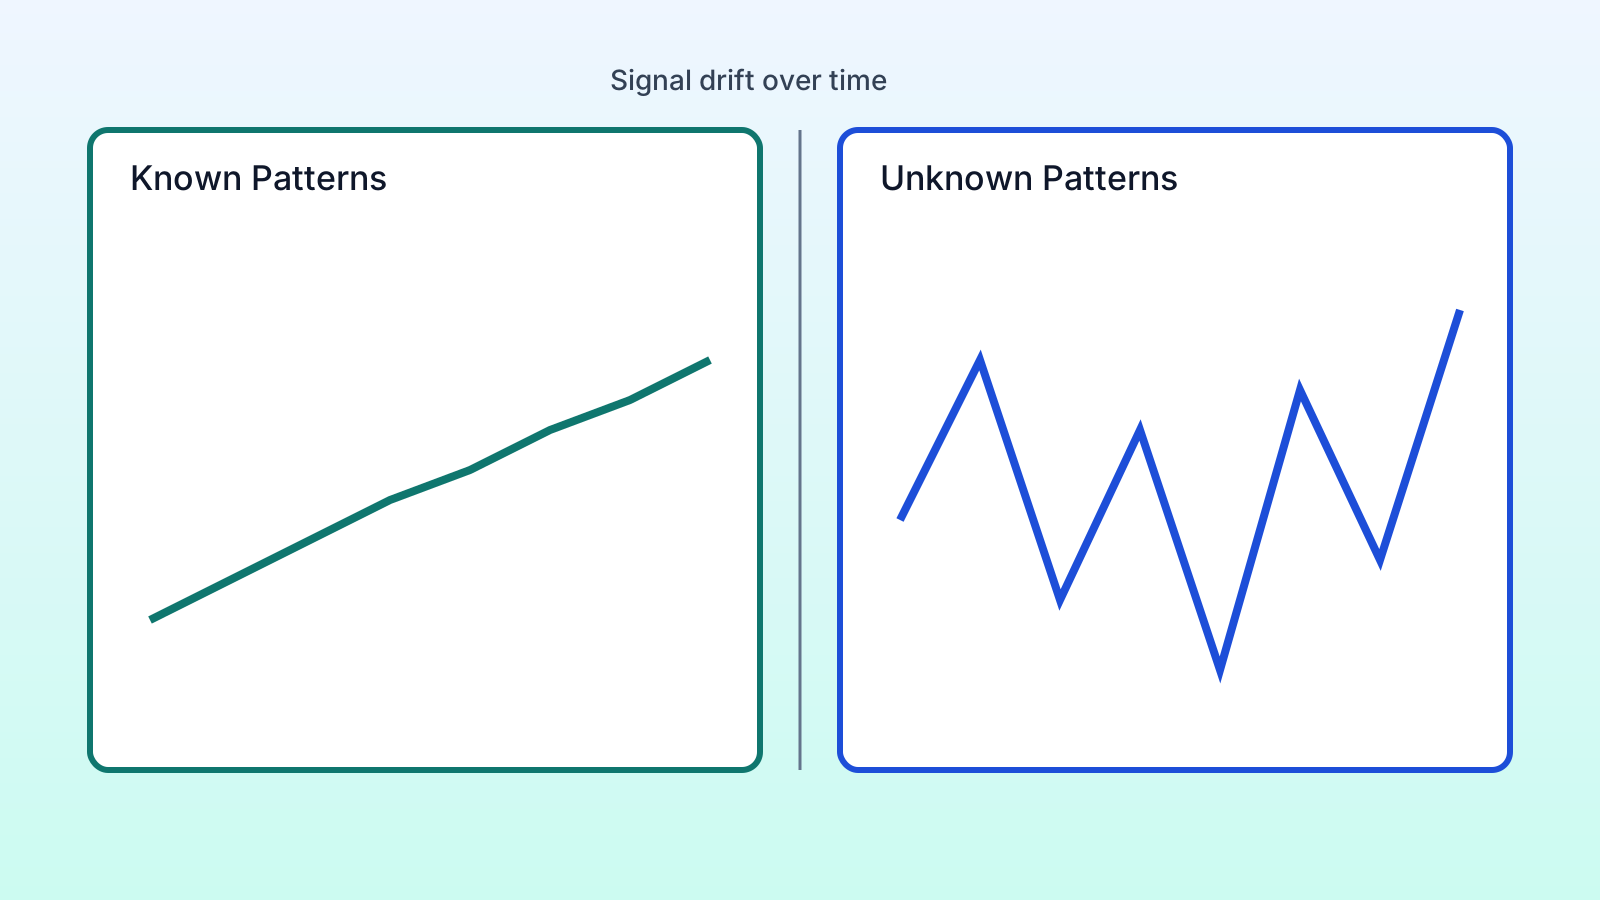
Supervised Learning ist stark - wenn Sie bereits wissen, wonach Sie suchen. Sie labeln Daten, trainieren Modelle und erkennen Muster, die Sie explizit definiert haben. Das passt, wenn Ausfallbilder verstanden sind, Labels stabil sind und das Ziel ist, genau diese Fälle über Anlagen und Standorte hinweg zuverlässig zu finden.
Der Haken: Es findet vor allem, was Sie schon gesehen haben. Was nicht im Trainingsvokabular steht, wird leicht übersehen. Im Betrieb zählt diese Lücke: neue Fehlerkombinationen, seltene Regime und subtile Drifts tauchen oft auf, bevor jemand das Label-Schema nachzieht.
Unsupervised Learning dreht die Logik um. Keine Labels. Keine festen Annahmen, wie „schlecht“ aussehen muss. Struktur, Cluster und Abweichungen kommen direkt aus den Daten. Das ermöglicht:
- versteckte Anomalien, die Sie nicht erwartet haben,
- frühe Signale, bevor Störungen überhaupt sauber in Tickets definiert sind,
- Einblicke jenseits fester Regeln und Schwellen.
In der Praxis nutzen reife Programme beides: Supervised skaliert bekannte Use Cases mit Präzision. Unsupervised zeigt, was Ihnen noch fehlt - und wo sich Labeling und Fachexpertise als Nächstes lohnt.
Supervised hilft, bekannte Use Cases zu skalieren. Unsupervised hilft zu entdecken, was Ihnen fehlt.
Wenn Sie mit Zeitreihendaten aus Produktion, Energie oder Logistik arbeiten, geht es nicht darum, welcher Ansatz „in Theorie gewinnt“ - sondern wie Sie beides so kombinieren, dass Teams schneller von Rohsignalen zu sicheren Entscheidungen kommen.
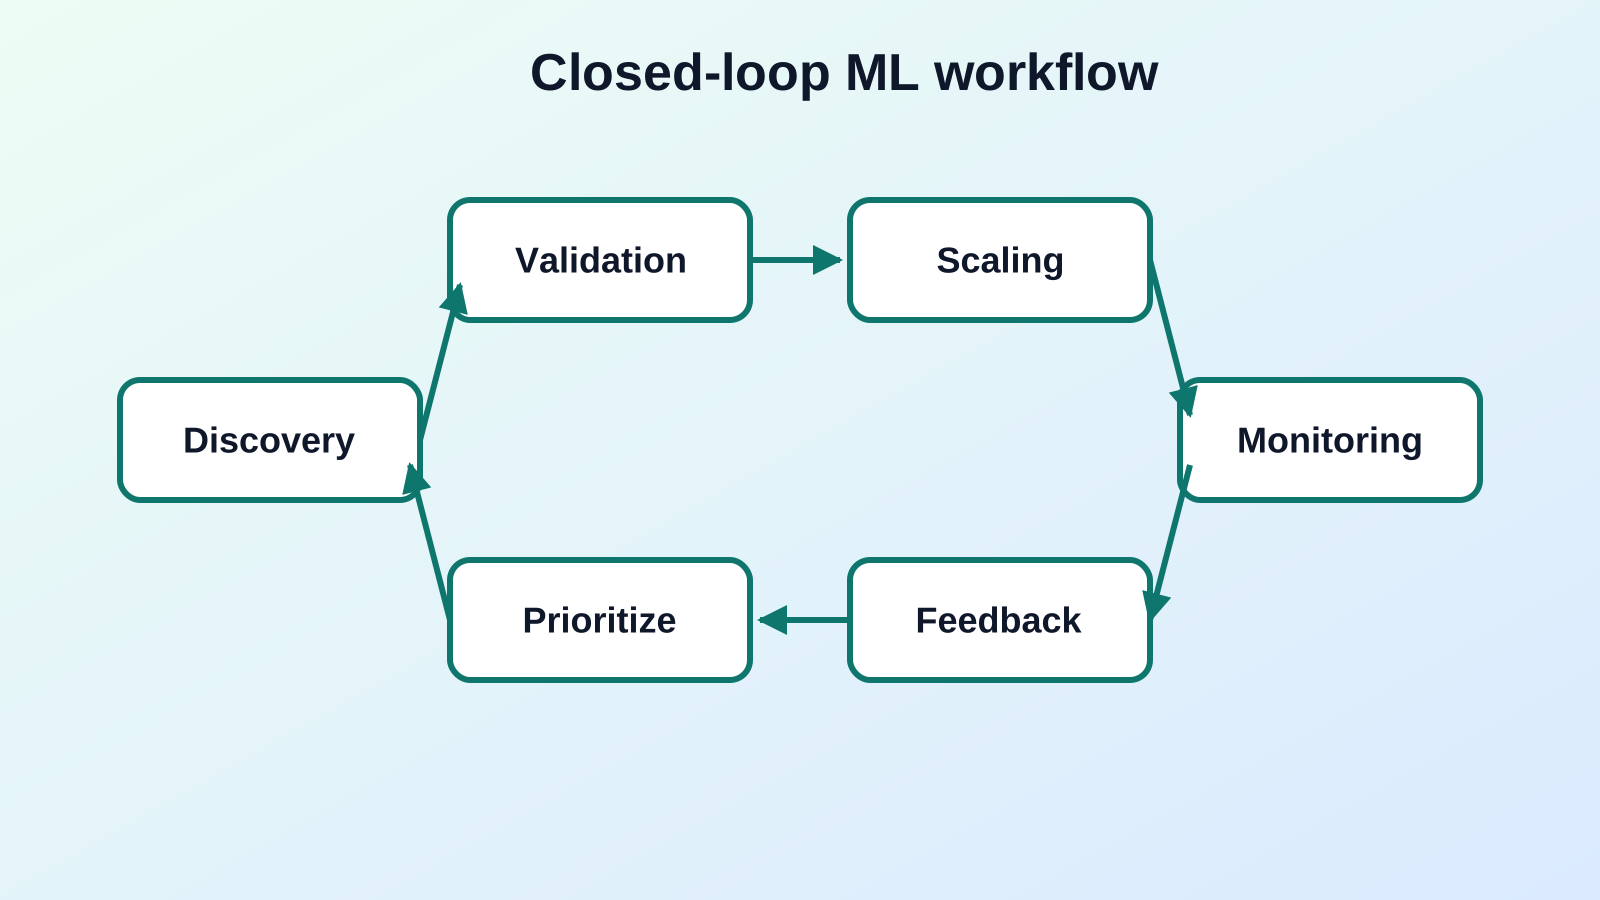
Ein praxisnaher Rollout funktioniert oft als geschlossener Zyklus: Unsupervised Signale identifizieren zunächst unbekannte Muster, Fachexpert:innen priorisieren die relevanten Fälle, und validierte Erkenntnisse werden anschließend als supervised Labels skaliert. So entstehen Vertrauen und messbarer Nutzen Schritt für Schritt.
Mehr dazu bei Predsense: https://www.predsense.ai/