Jeder erfahrene Operator hat es getan: ein Alarm ertoent, er quittiert ihn, ohne ihn wirklich zu lesen, und macht weiter. Das ist keine Nachlaessigkeit - es ist Alarmmuedigkeit, und sie ist einer der gefaehrlichsten Fehlermodi in einer modernen Anlage. Wenn Alarme zu viele, zu laut und zu undifferenziert sind, hoeren Menschen auf, ihnen zu vertrauen - und der eine Alarm, der wirklich zaehlte, wird mit dem Rest quittiert-und-ignoriert.
Dieser Beitrag beantwortet eine klar abgegrenzte Frage: Was verursacht Alarmmuedigkeit in der Fertigung tatsaechlich, und was koennen Sie dagegen tun?
Das sind die menschlichen Kosten lauter Alarme. Fuer die technische Loesung - Fehlalarme mit ML reduzieren - siehe unseren Beitrag zur Reduzierung von Fehlalarmen; dafuer, warum feste Grenzen echte Ereignisse auch *verpassen*, siehe, warum klassische Alarme fruehe Warnungen uebersehen.
Wie viel ist zu viel?
Das ist keine vage Klage - es ist gemessen. Alarmmanagement-Standards wie EEMUA 191 und ISA-18.2 setzen die handhabbare Rate im stabilen Betrieb auf etwa einen Alarm alle zehn Minuten - rund sechs pro Stunde - pro Operator. Darueber degradiert die menschliche Leistung schnell.
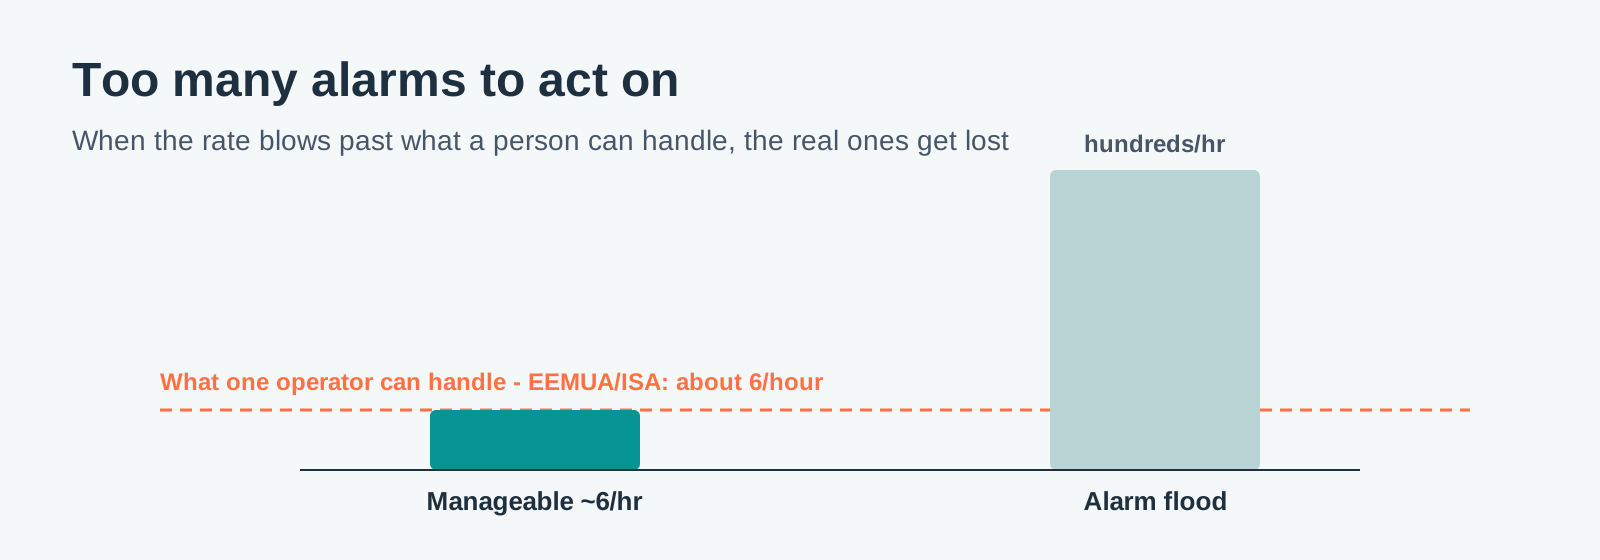
Reale Anlagen erzeugen routinemaessig so viele Alarme in einer *Minute*, besonders bei einer Stoerung, wenn eine einzelne Abschaltung in Dutzende Alarme kaskadiert - genau dann, wenn der Operator sie am wenigsten sortieren kann. Die handhabbare Rate und die Flut liegen nicht nah beieinander - sie sind Groessenordnungen auseinander.
Was Alarmmuedigkeit tatsaechlich verursacht
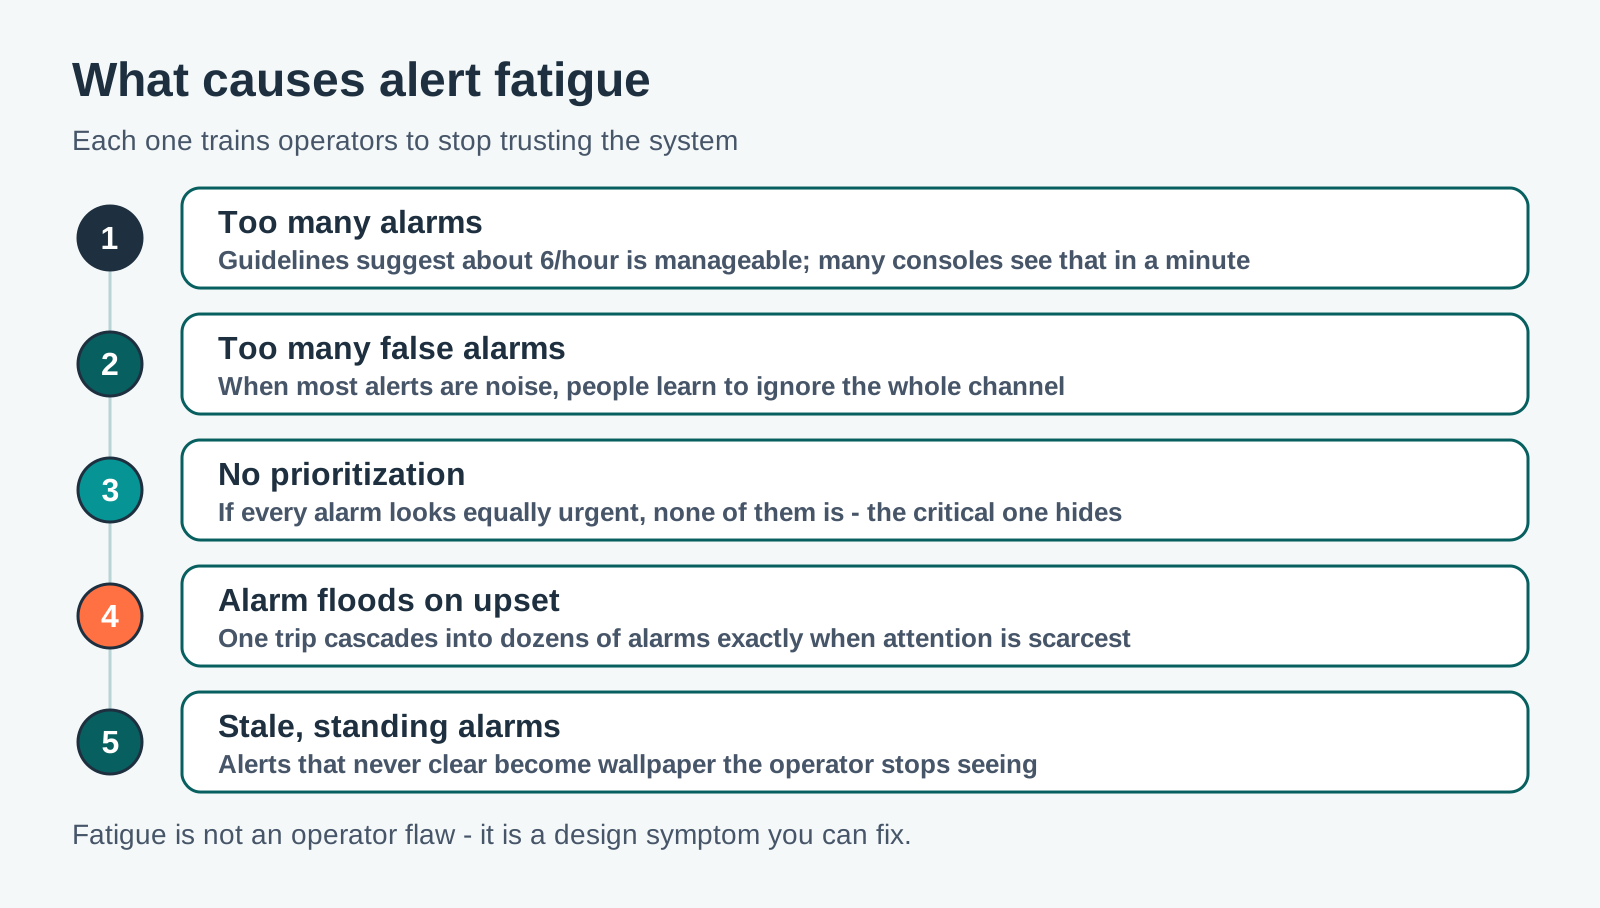
- Zu viele Alarme - die reine Rate liegt schlicht ueber dem, was ein Mensch verarbeiten kann.
- Zu viele Fehlalarme - wenn die meisten Alarme Laerm sind, lernen Menschen, dem ganzen Kanal zu misstrauen.
- Keine Priorisierung - wenn jeder Alarm gleich dringend aussieht, ist keiner es, und der kritische versteckt sich in der Liste.
- Alarmfluten bei Stoerungen - ein Ereignis loest eine Kaskade korrelierter Alarme im schlechtesten Moment aus.
- Alte, stehende Alarme - Alarme, die nie loeschen, werden zur Tapete, die der Operator nicht mehr sieht.
Jedes davon ist ein Design-Symptom, kein Operator-Fehler - was bedeutet, jedes ist behebbar.
Zwei Hebel, die es beheben
Erstens Alarm-Rationalisierung: das disziplinierte, standardbasierte Aufraeumen - Duplikate entfernen, Grenzen neu tunen und echte Prioritaeten vergeben. Zweitens ML-basierte Priorisierung und Unterdrueckung: eine Schicht, die Kontext lernt, erwartete zustandsbasierte Ausschlaege unterdrueckt, den Schweregrad bewertet und eine korrelierte Flut zu einem einzigen gerankten Ereignis zusammenfasst. Das Erste behebt die Konfiguration; das Zweite haelt die Rate handhabbar, waehrend sich die Bedingungen aendern. (Siehe unseren Beitrag zur Reduzierung von Fehlalarmen mit ML.)
Use Case in der Praxis: ein Pharma-Verpackungsleitstand
Eine Verpackungshalle betreibt mehrere Linien fuer feste Darreichungsformen - Blistern, Kartonieren, Serialisierung, Palettieren - in einem Leitstand. Jede Linie steuert Alarme bei; waehrend eines Staus an einem Kartonierer flutet eine Kaskade korrelierter Alarme (Drehmoment, Kamera, nachgelagerter Puffer, Serialisierungs-Mismatch) das gemeinsame HMI. Der Operator, der bereits vier Linien beobachtet, schaltet die Flut stumm, um nachzudenken - und schaltet damit alles stumm, auch eine echte Kaltsiegel-Drift, die an einer anderen Linie beginnt. Die Charge auf dieser Linie wird spaeter verworfen. Nichts hier ist Fahrlaessigkeit; es ist ein System, das mehr Alarme erzeugt, als ein Mensch triagieren kann.
Wie Sie die Loesung aufbauen wuerden
- Signale: der Alarmstrom selbst plus die zugrunde liegenden Prozessmesswerte je Linie - Drehmoment, Kameraergebnisse, Temperaturen, Pufferstaende, Serialisierungsstatus.
- Kontext: Linie, Zustand (Lauf / Wechsel / Stau / CIP), SKU und Batch, sodass erwartete Uebergaenge erkannt statt alarmiert werden.
- Was Sie labeln: historische Alarmfluten und welches einzelne Grundereignis sie ausloeste, plus welche seltenen Alarme einem echten Ausschuss vorausgingen, damit das Modell lernt, Kaskaden zusammenzufassen und die Wichtigen hervorzuheben. (Siehe unseren Beitrag, was Data Labeling ist.)
- Wer reagiert: Operatoren erhalten ein gerankte, entdupliziertes Ereignis statt vierzig; eine hochprioritaere Kaltsiegel-Drift taucht nun ueber einer unterdrueckten Stau-Kaskade auf, und die QS wird alarmiert, bevor die Charge verloren ist.
Ein kurzes Rechenbeispiel
Waehrend eines zweiminuetigen Kartonierer-Staus postet das rohe System ~40 Alarme - das Achtfache des stuendlichen EEMUA/ISA-Budgets in 120 Sekunden. Der Operator schaltet alles stumm. Eine Priorisierungsschicht fasst diese 40 zu einem "Kartonierer 2 Stau"-Ereignis zusammen und haelt die unabhaengige Kaltsiegel-Drift an einer anderen Linie mit hohem Schweregrad sichtbar. Gleiche Instrumente, gleiche Anlage - aber nun sieht der Operator zwei Dinge zum Handeln statt vierzig Dinge zum Ignorieren.
Praktische Regel
Alarmmuedigkeit wird nicht behoben, indem man Operatoren sagt, sie sollen besser aufpassen; sie wird behoben, indem man ihnen weniger, bessere Alarme schickt. Rationalisieren Sie die Konfiguration, dann lassen Sie ein Modell die Rate handhabbar und die Prioritaeten ehrlich halten - sodass, wenn ein Alarm ertoent, die Menschen ihm glauben.
Weniger, klugere Alarme beginnen mit gelabelter Historie. Bringen Sie dem System bei, welche Fluten zusammenzufassen und welche seltenen Signale hervorzuheben sind - Daten importieren, Kontext ergaenzen und die Ereignisse labeln, in Predsense Labeling: https://www.predsense.ai/products/labeling